RAG простыми словами: где теряется ответ, который есть в ваших документах
RAG обещают как лекарство от выдумок, но ответ чаще теряется до модели: в папках, в поиске, в нарезке. Где именно и как это проверить на настоящих вопросах.
- Чтение
- 9 мин
- Для кого
- Собственник или руководитель, которому предлагают «бота по вашим документам», и тот, кто такого бота уже собрал и не понимает, почему он ошибается
- Вопросов
- 4
- Мысль за этим
- 014
Коротко
- Самый опасный вопрос к боту — тот, на который в документах ответа нет. Хорошая система говорит «не нашёл», плохая отвечает по соседнему документу.
- Модель выбирают последней. Сначала — полсотни настоящих вопросов от клиентов и сотрудников и проверка, находит ли поиск нужный кусок.
- Если вся база меньше пятисот страниц, поиск можно не строить: её кладут в запрос целиком.
RAG (retrieval-augmented generation, генерация с поиском) — это способ заставить нейросеть отвечать по документам компании: базе знаний, регламентам, прайсам. Документы заранее режут на куски и складывают в поисковый индекс. Когда человек задаёт вопрос, система сначала находит несколько подходящих кусков. Потом отдаёт их модели вместе с вопросом: ответь по этим материалам. Модель ничего не запоминает и ничему не учится. Каждый раз она читает то, что ей принесли, и пересказывает.
Отсюда правило, которое стоит знать до покупки любого «бота по базе знаний»: он отвечает не лучше, чем ищет. Принёс поиск не тот кусок — самая умная модель грамотно и уверенно перескажет не тот кусок.
Как работает RAG: сначала поиск, потом ответ
Частей три: база, поиск и модель.
База — это ваши документы, нарезанные на куски. Обычно кусок не длиннее нескольких сотен токенов, то есть абзац-другой. Целый регламент модели не показывают: он не влезет в запрос или влезет, но обойдётся дорого.
Поиск бывает двух видов. Поиск по смыслу найдёт раздел «Возврат средств», даже если человек спросил «как вернуть деньги». Зато он путается в точных строках: артикулах, номерах договоров, кодах ошибок. Anthropic в той же статье приводит пример с запросом «Error code TS-999». Поиск по смыслу может пройти мимо, обычный поиск по словам найдёт эту строку сразу. Поэтому хорошие системы ищут обоими способами и складывают результаты.
Модель получает вопрос и несколько найденных кусков, обычно от пяти до двадцати. Всё, чего среди них нет, для неё не существует. С агентами для программирования та же история: что агент не прочитал, того в проекте для него нет.
Собрать такую систему в России можно из готовых частей. Например, в Yandex AI Studio есть поиск по файлам: PDF, сканы, таблицы, с марта 2026 года — аудио и видео. Если в документах есть персональные данные, сначала прочитайте, что можно отправлять в нейросеть по 152-ФЗ.
Скотт Барнетт с коллегами разобрали три RAG-системы и насчитали семь мест, где они ломаются. Модель виновата не во всех. Остальное случается раньше, по дороге от папки с документами до запроса.
В базе нет ответа, или их там три
Самый неприятный вопрос — тот, ответа на который в документах нет. Клиент спрашивает про доставку в Казахстан, а в базе только доставка по России. Поиск всё равно что-нибудь вернёт: он возвращает самые похожие куски, даже если похожи они так себе. Модель получает текст про Россию и отвечает про Казахстан. Складно и мимо.
У Барнетта это первая точка отказа: нужного документа нет, а система отвечает на похожий вопрос. Лечится инструкцией «если в материалах нет ответа, так и скажи». И обязательной проверкой, что инструкция работает: для этого в наборе вопросов нужны вопросы без ответа.
Обратная беда — ответ есть, и не один. Прайс за прошлый год, прайс за этот и «прайсфинал2» лежат в одной папке. Для поиска это три одинаково хороших документа. Какой из них попадёт к модели, решают формулировка вопроса и случай.
Чем это кончается, хорошо видно на деле Moffatt против Air Canada. Чат-бот авиакомпании сказал пассажиру, что льготу на билет в связи со смертью родственника можно оформить уже после поездки, в течение 90 дней с покупки билета. Страница о той же льготе на том же сайте говорила, что после поездки нельзя. В споре авиакомпания доказывала, что за слова чат-бота не отвечает. Трибунал Британской Колумбии в феврале 2024 года ответил: бот — часть сайта, а за всё на своём сайте компания отвечает сама. Как был устроен тот бот, из решения не видно. Но расклад узнаваемый: на один вопрос в компании два ответа, и клиент получил не тот.
Поэтому до индексации наводят порядок. Одна действующая версия каждого документа. Старые уходят в архив, по которому поиск не ходит. У каждого документа есть дата и человек, который отвечает за его актуальность. На демо этой работы не видно. Но без неё бот будет называть прошлогодние цены, пока кто-нибудь не пожалуется.
Поиск не нашёл нужный кусок
Система отдаёт модели только первые несколько найденных кусков. Если нужный оказался седьмым, а берут пять, модель его не увидит. Это вторая точка отказа у Барнетта: ответ в базе есть, но в первые строки выдачи не попал.
В Anthropic пробовали отдавать модели 5, 10 и 20 кусков, лучше всего сработали 20. Цифра не универсальная, но порядок понятен: пяти часто мало.
Вторая частая причина — вопрос с точной строкой: номер договора, артикул, фамилия. Такую строку и ловит поиск по словам, если он работает вместе с поиском по смыслу. Технология старая, дешёвая, и отказываться от неё ради одного «умного» поиска странно.
Кусок без начала
Нарезка рвёт связи внутри документа. В регламенте возвратов есть раздел «Товар надлежащего качества» и раздел «Товар с браком». В обоих есть строка про срок. После нарезки кусок «Срок — 14 дней» может остаться без заголовка. Модель видит только его и понятия не имеет, к какому случаю он относится.
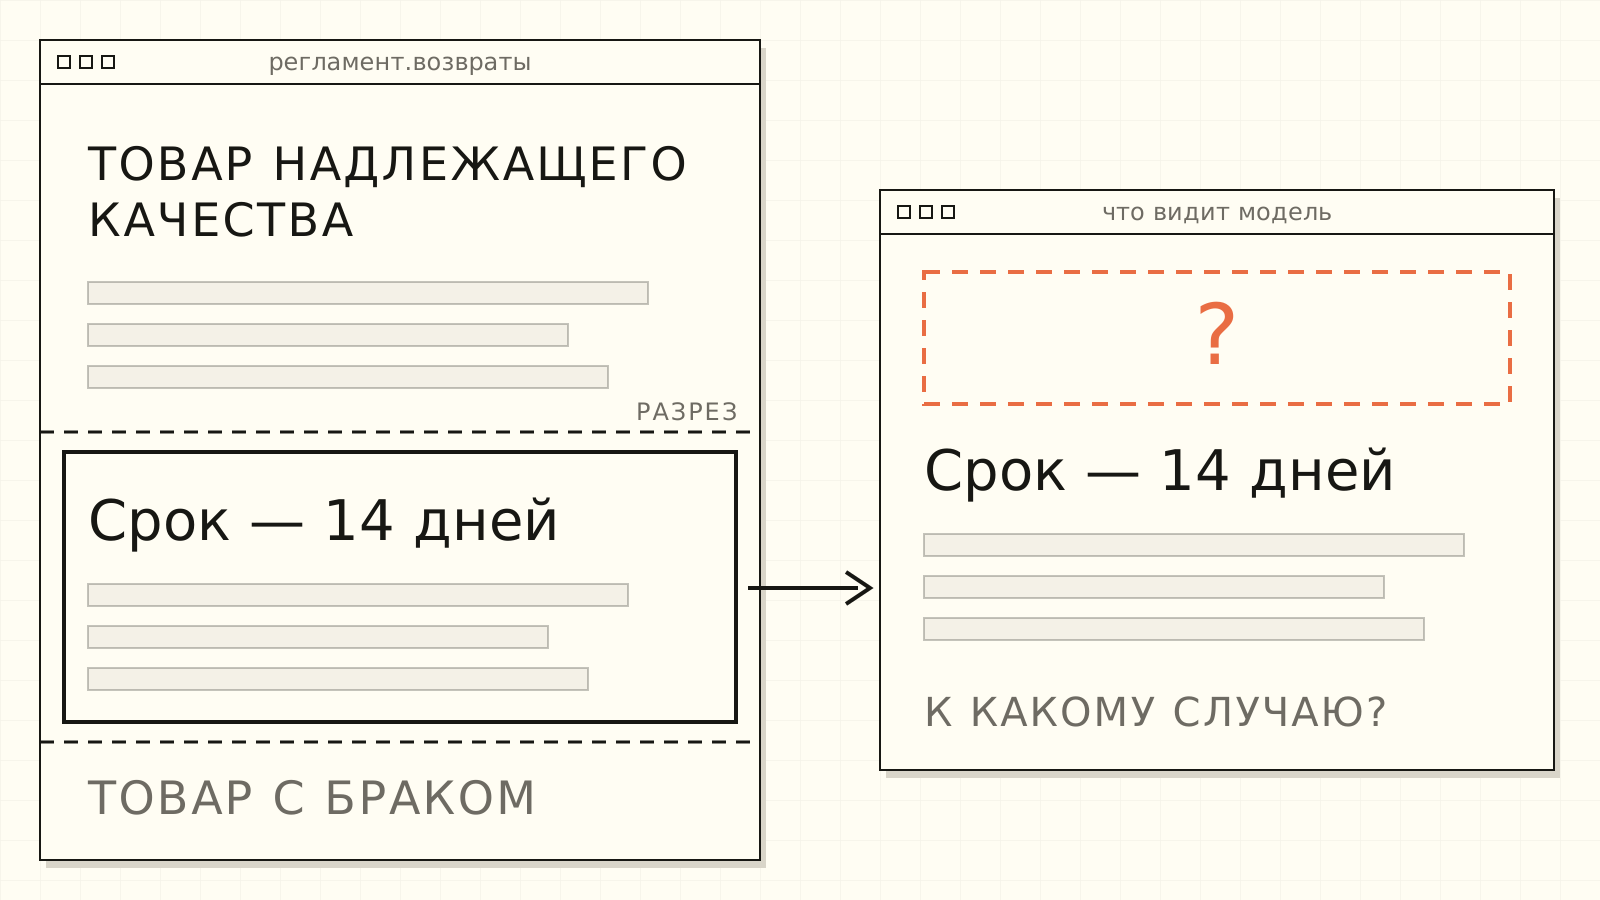
В Anthropic разбирали ту же беду на примере фразы «выручка выросла на 3% по сравнению с прошлым кварталом». Какой компании, какого квартала — из куска не понять. Решение у них простое: перед индексацией к каждому куску дописывают пару предложений о том, откуда он. Пишет их модель, которой показали весь документ. Доля неудачных поисков среди 20 найденных кусков упала с 5,7% до 3,7%. Вместе с поиском по словам — до 2,9%, а с дополнительной пересортировкой найденного — до 1,9%.
То есть ошибок поиска стало втрое меньше. Модель, которая пишет ответ, не трогали. Кускам просто вернули адрес.
Даже без таких приёмов можно сделать многое: резать по разделам документа, а не по числу знаков, оставлять в каждом куске заголовок раздела. Таблицы держать целиком. Половина таблицы без шапки — это просто числа.
Нашлось, но ответ всё равно не тот
Последние места на пути — внутри модели. Нужный кусок пришёл, а модель не вытащила из него ответ, ответила наполовину или слишком общо. У Барнетта таких точек четыре из семи.
Насколько это серьёзно, показали исследователи из Стэнфорда и Йеля. В 2024 году они прогнали 202 вопроса через юридические системы с поиском по базе законов и судебных решений. Производители обещали избавить юристов от выдумок, LexisNexis — ссылки на законы «на 100% без галлюцинаций». Lexis+ AI ошибся в 17% ответов, Westlaw AI-Assisted Research — в 33%.
Каждый шестой и каждый третий ответ. С базой законов и решений, которую эти компании ведут десятилетиями.
Самая коварная из найденных ошибок — ссылка на настоящий документ, который ответ не подтверждает. Под ответом стоит источник, источник открывается, документ существует. Написано в нём другое. Ссылка успокаивает, и открывать её уже не хочется.
Поэтому рядом с ответом бот должен показывать тот кусок, на который опирается. Одного названия документа мало. А на проверке открывать надо все ссылки.
Как проверить RAG до запуска: шаги
Барнетт с коллегами честно признают: проверить RAG-систему можно только в работе, а надёжность у неё нарастает постепенно. Заранее её не спроектируешь. Остаётся подойти к работе как можно ближе ещё до запуска.
- Соберите 30–50 настоящих вопросов: из почты, чатов поддержки, из того, что спрашивают новички. Не придумывайте их сами. Вы спросите словами из документа, а клиенты так не говорят.
- Для каждого вопроса запишите, где лежит ответ: документ и раздел.
- Добавьте 5–10 вопросов, ответа на которые в базе нет. Правильный ответ на них один: «в документах этого нет».
- Проверьте поиск отдельно от ответа: попал ли нужный кусок в найденные. Если нет, менять модель бессмысленно. Чините базу, нарезку или поиск.
- Только потом проверяйте ответы: совпадают ли они с документом и подтверждает ли показанный кусок то, что написано в ответе.
- Прогоняйте весь набор заново после любого изменения: новой модели, новой нарезки, новой партии документов.
- После запуска добавляйте в набор каждый вопрос, на котором бот ошибся или честно сказал «не знаю».
Главное в этом списке — порядок. Модель имеет смысл выбирать только после четвёртого шага. До него вы сравниваете модели на том, что им принёс сломанный поиск.
Подрядчику, который предлагает бота по базе знаний, можно задать один вопрос из третьего шага. Если демо отвечает на него уверенно и подробно, дальше можно не смотреть.
Пятьсот страниц
Весь этот поиск нужен потому, что база не помещается в запрос. Иногда помещается.
Anthropic в той же статье пишет прямо: если база меньше 200 тысяч токенов, а это около 500 страниц, её можно класть в запрос целиком. Кэширование запроса делает такой вариант быстрее больше чем вдвое и дешевле до 90%.
Прайс, регламент возвратов, условия доставки и сотня типовых ответов поддержки — это десятки страниц. Для такой базы нарезка, индекс и пересортировка — лишняя техника, в которой есть чему сломаться. Положите всё в запрос, оставьте по одной версии каждого документа и прогоните тот же набор вопросов. Вместе с вопросами без ответа: модель, которой показали всё, выдумывать не разучилась.
Поиск понадобится, когда база перестанет помещаться. Не раньше.
Частые вопросы
Чем RAG отличается от дообучения модели?
Дообучение меняет саму модель: её учат на ваших примерах, и знания оседают внутри. Это дорого, долго, и обновить один пункт прайса так не получится. RAG модель не трогает: документы лежат отдельно, их можно заменить хоть сегодня. Для ответов по документам почти всегда хватает RAG. Дообучение нужно, когда надо поменять манеру ответа или научить модель редкому формату, а не новым фактам.
Можно ли сделать RAG на своих серверах, без облака?
Можно: открытые модели и поисковые базы разворачивают внутри компании. Платить за это придётся железом и людьми, которые его обслуживают, а качество открытых моделей надо проверять тем же набором вопросов. Облачный вариант проще и быстрее. Свои серверы выбирают, когда документы нельзя выносить за периметр: коммерческая тайна, персональные данные, требования заказчика.
Что такое векторная база данных и нужна ли она для RAG?
Это хранилище, где каждый кусок текста лежит вместе с числовым «отпечатком» смысла. По таким отпечаткам и работает поиск по смыслу. Для небольшой базы отдельная система не нужна: векторный поиск умеют обычные базы данных, например PostgreSQL с расширением pgvector, и готовые облачные сервисы. Отдельная векторная база имеет смысл, когда кусков миллионы.
Как сделать, чтобы бот не показывал сотруднику документы, к которым у него нет доступа?
Права надо проверять на этапе поиска, до модели: каждый кусок хранит, из какого он документа и кому этот документ можно видеть, и поиск отбрасывает чужое. Просить модель «не рассказывай про зарплаты» бесполезно: если кусок попал в запрос, он может попасть и в ответ.