«Бэкапы у нас есть»: как проверить, что сайт из них поднимется
Архив проверяют все, восстановление — почти никто. Чего обычно нет в резервной копии сайта, как провести учения на чистом сервере и какие два числа они дают.
- Чтение
- 10 мин
- Для кого
- Владелец сайта или интернет-магазина, руководитель, которому сказали «бэкапы делает хостер», и разработчик, который эти копии настраивал
- Вопросов
- 5
- Мысль за этим
- 012
Коротко
- Копию сайта проверяет только восстановление на чистом сервере. Целый архив и зелёная галочка в панели говорят, что файл есть, но не говорят, что из него поднимется сайт.
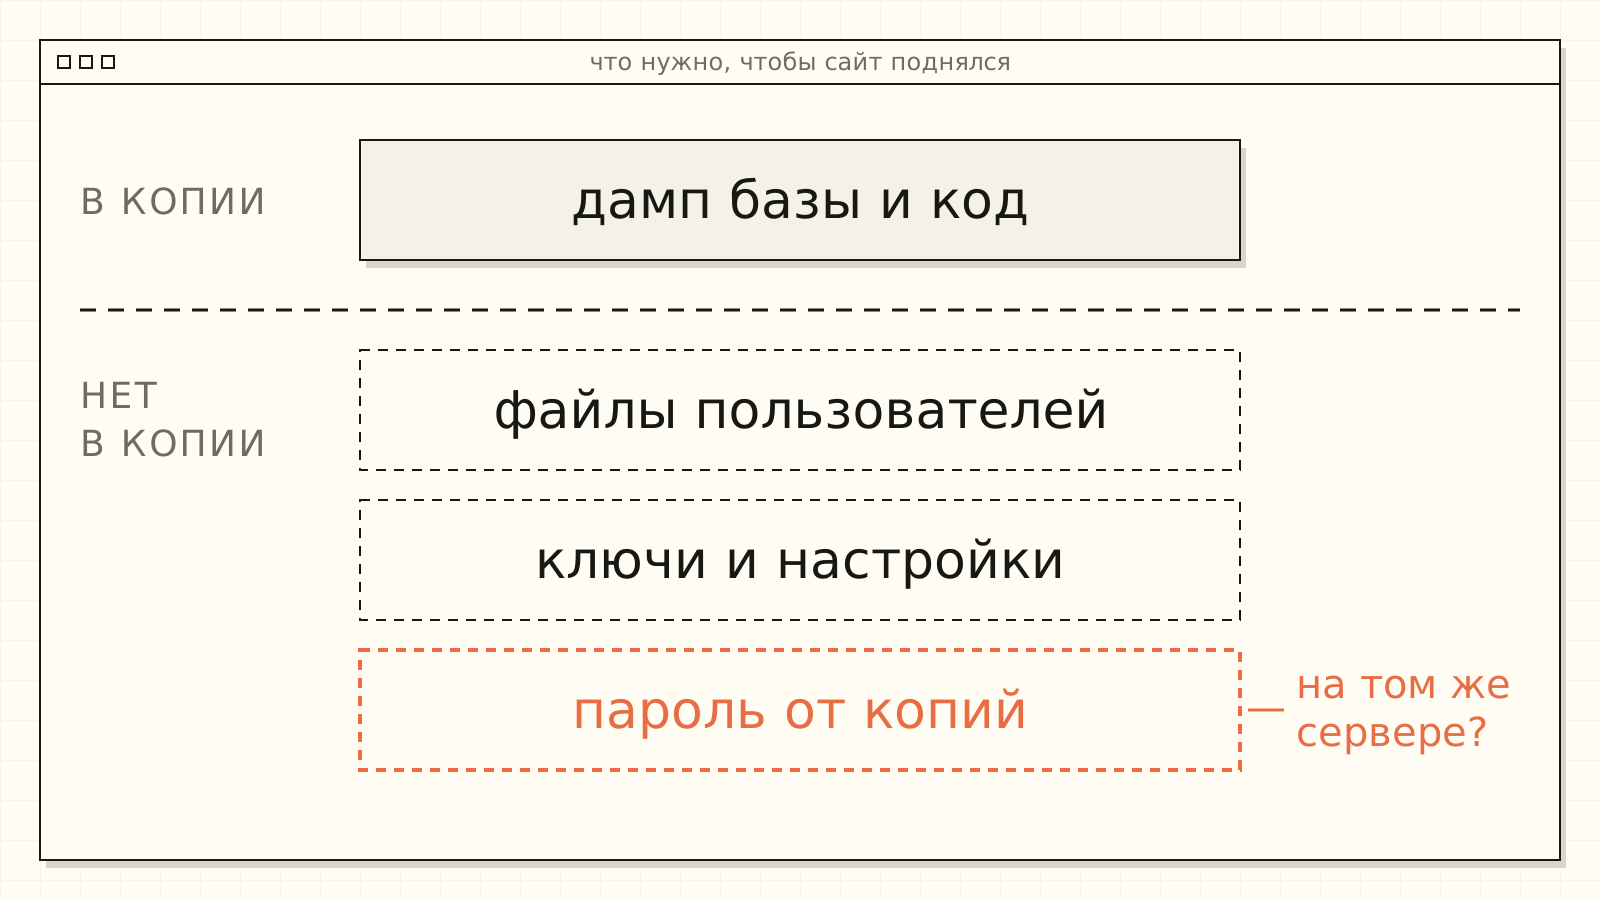
- Чаще всего в копии нет того, что лежит вне базы и кода: загрузок пользователей, ключей и настроек, ролей базы. И пароля от хранилища копий, если он хранился на том же сервере.
- Учения дают два числа: сколько часов работы потеряете и сколько часов будете без сайта. Оба стоит показать владельцу бизнеса и спросить, устраивают ли они его.
- Одна копия должна лежать вне сервера, вне аккаунта и вне здания, где работает сайт, и её нельзя удалить тем же паролем, которым входят на сервер.
- Ночные копии хостера — хороший первый слой. Своя копия у другого провайдера и учения раз в квартал всё равно нужны.
Резервная копия сайта — это всё, что нужно, чтобы поднять сайт заново на другом сервере: база данных, файлы, которые загружали пользователи, код нужной версии и настройки. Копии делают автоматически по расписанию и хранят минимум в двух местах, одно из которых вне сервера и вне аккаунта, где работает сайт. Проверить копию можно одним способом: восстановить из неё сайт на чистом сервере. Если сайт открылся, заказы и личные кабинеты на месте и вы знаете, сколько часов это заняло, копия у вас есть. Если нет, у вас архив, про который пока ничего не известно.
Ошибаются обычно в проверке. Смотрят, что архив создан, весит прилично и открывается. Это проверка файла. Сайт из него может не подняться, и узнают об этом в день аварии. Поэтому начинать я бы стал с вопроса, который к архиву вообще не относится: где лежит пароль от хранилища копий. Если только на том сервере, который вы собираетесь из этих копий поднимать, расписание и формат архива можно пока не обсуждать.
Что входит в резервную копию сайта, а чего в ней нет
Типичная копия небольшого сайта — ночная выгрузка базы (дамп) и архив папки с сайтом. Пока всё лежит на одном сервере, этого почти хватает. Потом сайт растёт, и нужное для восстановления расползается по местам, о которых расписание копий не знает.
Картинки товаров и документы клиентов переезжают в отдельное файловое хранилище, и в архив папки они больше не попадают. Ключи платёжного сервиса и почты лежат в файле настроек .env, который из копий нередко исключают, и правильно: там секреты. Только и отдельно его потом часто никто не сохраняет.
У баз отдельная ловушка. В PostgreSQL обычная выгрузка pg_dump не сохраняет роли и права. В документации так и сказано: эти объекты общие для всего сервера, и в выгрузку отдельной базы они не попадают. Восстанавливаете базу на чистом сервере — и получаете ошибки про пользователя, которого не существует.
GitLab: четыре способа копирования, и ни один не спас
Хрестоматийный разбор на эту тему опубликовал GitLab. В январе 2017 года инженер по ошибке стёр рабочую базу GitLab.com, когда чинил сломавшуюся реплику. Компания полезла в копии, и выяснилось, что из четырёх способов защиты не помогает ни один.
Ночная выгрузка базы шла программой версии 9.2 против сервера версии 9.6 и падала с ошибкой. Хранилище для неё было пустым. Письма об ошибках отправлялись, но почтовый сервер их отклонял, так что про сбой никто не знал. Снимки дисков в облаке включили для файловых серверов, а для серверов базы — нет: решили, что других копий хватит. Реплика к тому моменту уже отстала и тоже не годилась.
Спас снимок диска, который инженер сделал руками примерно за шесть часов до сбоя. Он лежал в тестовой среде на медленных дисках, и данные из него переносили около 18 часов — примерно столько же сайт и не работал. Шесть с лишним часов работы пользователей пропали: примерно 5 000 проектов, 5 000 комментариев и 700 новых учётных записей.
Главная строка в отчёте про людей. У процедуры копирования не было владельца, и никто не отвечал за её проверку. Четыре способа, и все ничьи.
Похожая история про механизм, который все считают рабочим, хотя руками его никто не пробовал, — в эссе про стоп-кран для ИИ-агента.
Как проверить резервную копию: учения на чистом сервере
В книге Google про эксплуатацию сервисов есть глава про сохранность данных. Главная мысль оттуда звучит почти как шутка: копии никому не нужны, всем нужно восстановление. Там же сказано, что восстановление работает, только если его регулярно отрабатывать.
Отрабатывать — значит провести учения. На небольшой сайт уходит полдня.
- Назначьте человека. Лучше того, кто копии не настраивал. Тот, кто настраивал, держит в голове шаги, которых нет ни в одной инструкции, и пройдёт их, не заметив.
- Возьмите чистый сервер. Новую виртуальную машину на день или ноутбук. Не тестовую среду, где уже всё стоит.
- Достаньте копию так, будто рабочего сервера нет. С другого компьютера, без входа на сайт. Здесь и выясняется, где пароль от хранилища и у кого он есть.
- Восстановите базу той же версии. Для PostgreSQL сначала роли (pg_dumpall --globals-only), потом саму базу. Версию сервера базы берите ту же, что в работе.
- Разверните код и настройки. Каждую строку .env, которую пришлось искать в переписке или вспоминать, запишите. Ключи платежей и отправку писем на стенде отключите.
- Верните загруженные файлы. Картинки товаров, документы, аватарки.
- Пройдите сайт как пользователь. Войдите в личный кабинет, откройте последний заказ, найдите товар с картинкой, отправьте форму на тестовый адрес.
- Запишите время и найденное. Сколько часов заняло всё целиком, какая последняя запись есть в базе и что пришлось искать. Найденное исправьте, следующие учения поставьте через три месяца.
- Копию досталичерез 40 мин · пароль искали
- База подняласьсо второй попытки · не было ролей
- Картинки товаровнет в копии
- Сайт открылсячерез 3 ч 50 мин
- Последний заказ в базевчера, 02:00
Как часто делать резервную копию: два числа после учений
После учений у вас появляются два числа, которых до них не было ни у кого.
Первое — сколько работы вы потеряете. Если копия ночная, а сайт упал в шесть вечера, пропадёт всё, что случилось за шестнадцать часов: заказы, заявки, правки в каталоге. В терминах это RPO (recovery point objective). Американский институт стандартов NIST определяет его как момент времени, на который данные должны вернуться после сбоя.
Второе — сколько часов вы будете без сайта, это RTO (recovery time objective). В журнале выше — почти четыре часа, и это на спокойную голову, днём, со списком шагов.
Отсюда и ответ на вопрос, как часто делать копию. Частоту выводят из того, сколько работы не жалко: ночная копия — до суток потерь, ежечасная — до часа. Файлы сайта меняются реже базы, их обычно хватает копировать раз в сутки.
Оба числа стоит показать владельцу бизнеса и спросить прямо: «Потерять шестнадцать часов заказов — нормально?» Если нет, копировать базу надо чаще. Или включить непрерывное копирование журнала изменений: тогда базу можно вернуть почти на любую минуту. Этот вариант GitLab после аварии и взялся изучать. Если четыре часа простоя — слишком долго, надо сокращать шаги: записать их в инструкцию, автоматизировать, держать готовый образ сервера.
Где хранить резервные копии: правило 3-2-1
Правило 3-2-1 придумал фотограф Питер Крог для архивов фотографий, в книге 2006 года. Три копии данных, на двух разных видах носителей, одна в другом месте. Для сайта «другое место» означает другое здание и другой аккаунт.
Здание — не фигура речи. В марте 2021 года в Страсбурге сгорел дата-центр OVHcloud. Двое клиентов потом выиграли у провайдера суды на 101 и 154 тысячи евро, пишет Blocks & Files. У обоих копии оказались на той же площадке, что и рабочий сервер, у одного — прямо в том же здании. Ему в договоре обещали, что резервное копирование физически отделено от сервера.
Отдельный аккаунт нужен по другой причине. В 2023 году Veeam опросила 1 200 компаний, переживших атаки вымогателей. В 93% атак злоумышленники пытались добраться до хранилищ копий. Три четверти пострадавших потеряли хотя бы часть копий, 39% хранилищ пропали целиком. Логика простая: шифровать сайт имеет смысл, только если его нельзя восстановить.
Отсюда практическое правило. Ключ, который лежит на сервере, должен уметь только добавлять копии в хранилище, но не удалять их. Ещё лучше, если хранилище само запрещает удаление на заданный срок — такая настройка есть у многих облачных хранилищ. Если сайт правит ИИ-агент, к копиям у него тоже не должно быть доступа.
Хостер делает копии. Этого хватит?
Для первого слоя — да. Например, Timeweb на виртуальном хостинге копирует файлы и базы каждую ночь и хранит копии 30 дней. Это закрывает обычную аварию: кто-то удалил не то или обновление сломало сайт.
Тяжёлую аварию это не закрывает. Копии хостера живут у того же провайдера и открываются из того же аккаунта. Взломали аккаунт, его заблокировали, у провайдера сгорел дата-центр — вы теряете сайт и копии одновременно. Так в мае 2026 года вышло у клиентов THE.Hosting и UFO.Hosting. После «технического сбоя» поддержка сообщила, что их VPS не восстановить, а по словам пользователей, вместе с серверами пропали и резервные копии (SecurityLab).
Поэтому копии хостера оставьте, а раз в неделю выгружайте свою к другому провайдеру. И учения проводите на обеих: копию хостера можно восстановить в соседний тестовый сайт прямо из панели. Если вы держите n8n на своём сервере, его база со сценариями и доступами — такой же кандидат в копии, как и база сайта.
Первые учения
Новую систему копий я бы на этой неделе не настраивал. Сначала возьмите последнюю копию, которая у вас уже есть, и попробуйте поднять из неё сайт по шагам выше. На это уйдёт полдня.
Скорее всего, найдётся одно из трёх: пароль от копий знает один человек, загрузок пользователей в копии нет, база без ролей не встаёт. Каждое чинится за вечер. Если всё поднялось с первого раза, запишите, сколько это заняло, и поставьте следующие учения в календарь на январь.
Частые вопросы
Как часто делать резервную копию сайта?
Так часто, сколько данных вы готовы потерять. Ночная копия значит, что при аварии пропадёт до суток заказов, заявок и правок. Для сайта-визитки это нормально. Для магазина с сотней заказов в день — уже нет: базу копируют каждый час или включают непрерывное копирование журнала изменений, а файлы сайта можно и раз в сутки.
Хостер делает бэкапы — нужно ли делать свои?
Нужно. Копии хостера хранятся у того же провайдера и открываются из того же аккаунта, что и сайт. Если аккаунт взломают, заблокируют или у провайдера случится авария, вы теряете и сайт, и копии сразу. Держите копии хостера как первый слой и раз в неделю выгружайте свою копию к другому провайдеру.
Как проверить резервную копию, не трогая рабочий сайт?
Восстановите её на отдельном сервере или на своём компьютере. Рабочий сервер при этом не нужен вообще: копию надо достать так, будто его уже нет. Отправку писем и платёжные ключи на тестовой копии отключите, иначе клиенты получат письма со стенда.
Где хранить резервные копии сайта?
По правилу 3-2-1: три копии данных, на двух разных видах носителей, одна в другом месте. Для сайта это обычно рабочий сервер, копии хостера и хранилище у другого провайдера. У последнего отдельный аккаунт, а ключ с сервера умеет только добавлять копии, но не удалять их.
Что такое RPO и RTO?
RPO (recovery point objective) — на какой момент данные должны вернуться после сбоя, то есть сколько последних часов работы вы готовы потерять. RTO (recovery time objective) — за сколько времени сайт должен снова заработать. Первое задаёт частоту копий, второе — насколько отлажено восстановление. Оба числа честно известны только после учений.